Claude Fable 5.2は、Anthropicが2026年11月に公開したClaudeの最上位モデルとして注目を集めています。
ただ、5.1から何が変わり、料金はいくらかかるのか、迷う方も多いのではないでしょうか。
実は5.2では、API料金が2割安くなり、回答も速くなっています。
この記事では、Claude Fable 5.2の料金と使い方から、5.1との違いやOpus 5.5との使い分けまで解説します。
自分の作業に合った使い方を選べるようになりましょう。
- Claude Fable 5.2はAnthropicが2026年11月9日に公開したClaudeの最上位モデルで、Fable 5.1よりAPI料金が2割安く、回答が最大3割速い
- API料金は100万トークンあたり入力8ドル(約1,280円)・出力40ドル(約6,400円)で、Opus 5.5のちょうど2倍
- claude.aiではFreeプランでは使えず、Max・Ultraは週の上限の半分まで追加料金なし、Pro・Team標準席は使用量クレジットでの従量払いになる
- 日々の作業はOpus 5.5に任せ、数日がかりの開発や原因の分からない不具合の調査にFable 5.2を使うのがおすすめ
生成AIパスポート取得者が内容をチェック
当サイトの記事は、生成AIに関する基礎知識やリスク、適切な活用方法などを学ぶ「生成AIパスポート」の取得者が内容を確認しています。情報の正確性や分かりやすさを意識した記事づくりに努めています。
Claude Fable 5.2とは?
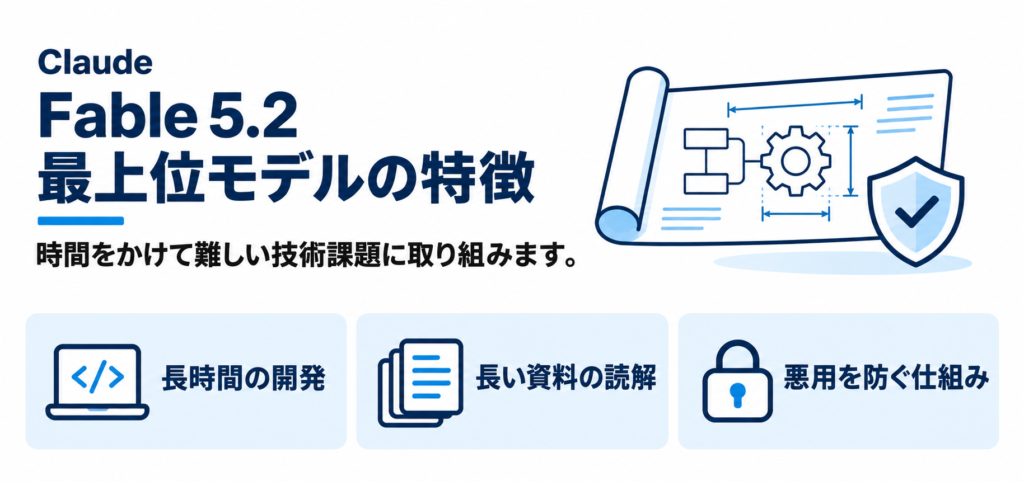
Claude Fable 5.2は、Anthropicが2026年11月9日(米国時間、日本時間では10日)に公開したClaudeの最上位モデルです。
Anthropicはこのモデルを、答えが決まっていない難しい技術作業を長時間続けるためのモデルと位置づけています。
同じ日に発表されたMythos 5.2とは中身が同じで、違うのは安全策の強さです。
Fableはサイバー攻撃や生物兵器につながる悪用を防ぐ仕組みを強めたうえで、有料プランの利用者全員に提供されています。
一方のMythos 5.2は、Anthropicの審査プログラムに申し込み、認められた組織だけが使えるモデルです。
一度に読み込める量は100万トークンで、トークンはAIが文章を処理する単位を指します。
1回に出力できる量は12万8,000トークンで、2026年6月までの情報を学習しています。
APIで呼び出すときのモデル名は claude-fable-5-2 で、Fableシリーズの中ではFable 5、Fable 5.1に続く3つ目のモデルです。
Fableシリーズ最初のモデルであるFable 5の特徴は以下記事にまとめてあるので、シリーズの成り立ちから知りたい方は参考にしてください。
参考:Claude Fable 5.2(Claude Platform Docs)
Claude Fable 5.2とFable 5.1の違い
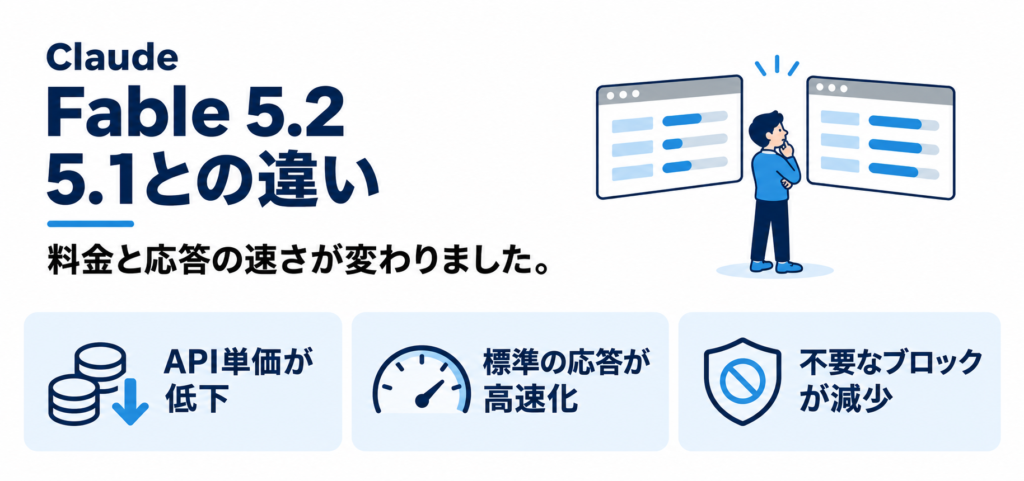
Claude Fable 5.2とFable 5.1の違いは、API料金・標準の速さ・新しいfast mode・安全策の精度の4つです。
一度に読み込める量と出力の上限は、5.1から変わっていません。
5.1と5.2の主な違いは、次の表のとおりです。
| 項目 | Fable 5.2 | Fable 5.1 |
|---|---|---|
| API料金(入力/出力) | 8ドル(約1,280円)/40ドル(約6,400円) | 10ドル(約1,600円)/50ドル(約8,000円) |
| キャッシュ読み取り | 0.20ドル(約32円) | 0.25ドル(約40円) |
| 標準の出力速度 | 5.1より最大30%速い | 基準 |
| fast mode | あり(最大2.5倍速) | なし |
| 安全策による不要なブロック | 5.1より約55%少ない | 基準 |
| 読み込める量/出力の上限 | 100万/12万8,000トークン | 同じ |
料金は100万トークンあたりの金額で、いずれも2026年11月14日時点の公式発表の値です。
円の目安は1ドル=160円(2026年11月13日時点)で計算しています。
ここでは、4つの違いを公式の数値と合わせて紹介します。
API料金が入力・出力とも2割下がった
Claude Fable 5.2のAPI料金は、100万トークンあたり入力8ドル(約1,280円)・出力40ドル(約6,400円)です。
Fable 5.1は入力10ドル(約1,600円)・出力50ドル(約8,000円)だったため、どちらも20%の値下げになりました。
キャッシュ(一度読み込ませた資料を再利用して料金を抑える仕組み)の読み取り単価も、0.25ドル(約40円)から0.20ドル(約32円)に下がっています。
キャッシュの書き込み単価は、入力の1.25倍にあたる10ドル(約1,600円)です。
5.1と同じ設定・同じ作業量なら、請求額はおよそ8割に収まる計算です。
ただし、推論の深さ(回答の前にどれだけ考えるかを決める設定)を上げるほど使うトークンが増えるため、1回あたりの費用は設定によって変わります。
参考:Pricing(Claude Platform Docs)
標準料金のまま回答が最大3割速くなった
Claude Fable 5.2は、追加料金のかからない標準の設定でも、Fable 5.1より最大30%速く回答を出力します。
Fable 5.2に長い文章やコードを書かせるときほど、待ち時間の差は大きくなります。
この30%はAnthropicが自社の条件で測った最大値で、どの作業でも同じだけ速くなるとはかぎりません。
公式の速度の区分では、中程度(Moderate)に分類されています。
軽い質問に素早く答えるHaiku 5.5のようなモデルと比べると、速さで選ぶモデルではない点は変わりません。
それでも単価が下がったうえで速くなったため、料金と待ち時間の両方で5.1より使いやすくなりました。
参考:Claude Fable 5.2(Claude Platform Docs)
追加料金で回答を最大2.5倍速くできるようになった
Claude Fable 5.2では、追加料金を払うと出力を最大2.5倍速くできるfast modeを選べます。
fast modeはFable 5.1にはなく、5.2で新しく加わった選択肢です。
料金は100万トークンあたり入力16ドル(約2,560円)・出力80ドル(約12,800円)で、標準のちょうど2倍です。
使えるのはClaude Code、Claude API、Google Cloud、Microsoft Foundryの4つで、claude.aiのチャット画面は含まれません。
Microsoft Foundryでは、claude-fable-5-2-fast という別のモデル名で呼び出します。
不具合の修正を急ぐときのように、費用より待ち時間を減らしたい場面に絞ると、料金が膨らむのを防げます。
参考:What’s new in Claude Fable 5.2(Claude Platform Docs)
安全策による不要なブロックが約半分に減った
Claude Fable 5.2は、問題のない依頼まで安全策で止めてしまう回数が、Fable 5.1より約55%減りました。
分野別では、サイバーセキュリティで約60%、生物学で約40%の減少です。
Fableには、攻撃用のプログラム作成や生物兵器につながる依頼を防ぐ安全策が組み込まれています。
安全策の判定が厳しすぎると、脆弱性の調査や研究の質問のような正当な依頼まで止まってしまいます。
5.2では判定の精度が上がり、こうした作業を途中で中断される場面が少なくなりました。
止められた依頼を言い換えて送り直す手間が減るため、セキュリティの担当者や研究者ほど違いを感じやすい改善です。
ただし安全策そのものがなくなったわけではなく、危険と判定された依頼は止められるか、別のモデルに切り替わります。
参考:Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic)
ベンチマークで見るClaude Fable 5.2の性能
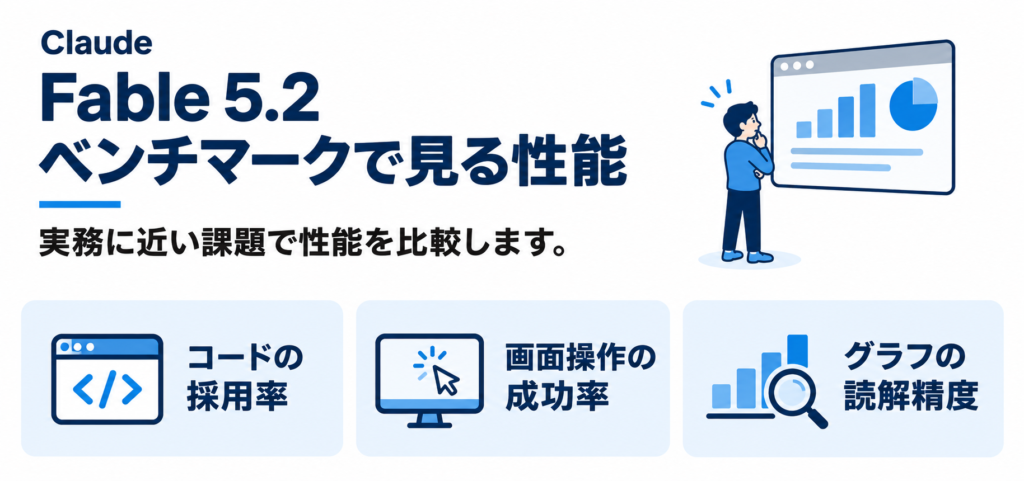
Claude Fable 5.2は、Anthropicが公表した評価のうち、主な10項目でFable 5.1とOpus 5.5を上回りました。
数値は安全策を有効にした状態で、特に記載のない項目は各モデルの最も高い推論設定で測ったものです。
例外はFrontierCode 2.0のxhigh(上から2番目の設定)と、Remote Labor Indexのhighです。
なお、表にない資料作成の評価(AA-Briefcase v1.1のElo)では、Opus 5.5の1800がFable 5.2の1785を上回っています。
| 評価(測る内容) | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0(採用されるコード) | 49.1% | 32.4% | 45.5% |
| FrontierSWE v2(実在の不具合修正) | 69.9% | 56.3% | 62.3% |
| AutomationBench(業務の自動化) | 51.4% | 31.4% | 42.5% |
| Terminal-Bench-Science 0.1(研究用のコマンド操作) | 74.6% | 52.6% | 58.7% |
| WANDR(AIによる調べもの) | 82.1% | 68.7% | 72.3% |
| OSWorld 2.1(パソコンの画面操作) | 89.3% | 83.5% | 87.2% |
| RoboDojo Sim(ロボットの制御) | 64.9% | 27.6% | 39.4% |
| Remote Labor Index(仕事の代行) | 41.3% | 17.9% | 21.3% |
| Humanity’s Last Exam・ツールあり(難問への解答) | 74.2% | 65.6% | 67.7% |
| Chartography・ツールなし(グラフの読み取り) | 73.4% | 44.8% | 64.4% |
開発者に採用されるコードを書く力でOpus 5.5を上回った
Claude Fable 5.2が書いたコードは、Opus 5.5より高い割合で実際の開発者に採用されました。
FrontierCode 2.0は、AIが作った修正をオープンソースの管理者が取り込むかどうかで測る評価です。
xhighの設定で測ったFable 5.2は49.1%となり、Fable 5.1の32.4%とOpus 5.5の45.5%を上回りました。
実在の不具合を直す力を測るFrontierSWE v2でも、69.9%とOpus 5.5の62.3%を超えています。
とはいえ、半分以上の修正はまだ取り込まれていない水準です。
AIが書いたコードは、人が中身を確かめてから使いましょう。
参考:Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic)
人の仕事を最後まで代行できる割合が5.1の2倍を超えた
Claude Fable 5.2が人の仕事を最後まで仕上げられた割合は41.3%で、Fable 5.1の17.9%から2倍以上に伸びました。
Remote Labor Indexは、実際にフリーランスへ発注された案件を、納品できる品質で仕上げられるかを測る評価です。
この数値はhighの設定で測ったもので、Opus 5.5の21.3%と比べてもおよそ2倍の差がついています。
一方、業務の流れを自動で進める力を測るAutomationBenchでは、Gemini 4 Carbonの53.9%がFable 5.2の51.4%を上回りました。
すべての評価で1位というわけではないので、自分の業務に近い評価の数値で比べましょう。
参考:Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic)
パソコンの画面操作の成功率が9割に迫った
Claude Fable 5.2がパソコンの画面を操作して課題をこなせた割合は、89.3%でした。
OSWorld 2.1は、AIが画面を見ながらマウスやキーボードを動かし、アプリの操作を完了できるかを測る評価です。
Fable 5.1は83.5%、Opus 5.5は87.2%で、もともと高い水準からさらに数ポイント伸びています。
表計算ソフトへの転記やブラウザでの入力のように、人が画面でおこなう定型作業をAIに任せやすくなった数値といえます。
失敗が減るほど、AIが途中で止まって人が作業を引き継ぐ場面も少なくなるでしょう。
ただし評価でも1割ほどは失敗しているため、お金や個人情報が絡む操作は最後に人が確認してください。
参考:Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic)
グラフの読み取り精度が5.1の約1.6倍になった
Claude Fable 5.2がグラフや図表から正しく数値を読み取れた割合は73.4%で、Fable 5.1の44.8%から約1.6倍に伸びました。
Chartographyは、ツールを使わずに画像のグラフだけを見て質問に答えられるかを測る評価です。
Opus 5.5の64.4%も上回っており、5.2で大きく伸びた分野の1つです。
入力には画像も使えるため、紙の資料をスマホで撮影したグラフを読ませる使い方もできます。
AIにPDFの決算資料や会議資料のグラフを読ませて要点をまとめる作業では、数値の読み違いが減ることが期待できます。
5.1で読み違いが気になった資料があれば、同じ資料をFable 5.2にも読ませて結果を見比べてみてください。
参考:Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic)
Claude Fable 5.2の料金
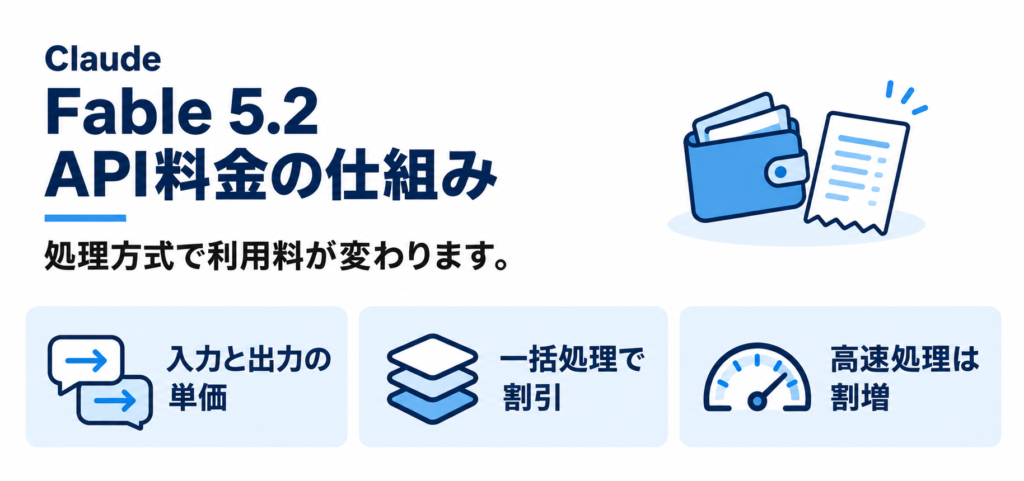
2026年11月14日時点のClaude Fable 5.2のAPI料金は、次の表のとおりです(円の目安は1ドル=160円・2026年11月13日時点)。
| 項目 | 料金(100万トークンあたり) |
|---|---|
| 入力 | 8ドル(約1,280円) |
| 出力 | 40ドル(約6,400円) |
| キャッシュ書き込み(5分保持) | 10ドル(約1,600円) |
| キャッシュ書き込み(1時間保持) | 16ドル(約2,560円) |
| キャッシュ読み取り | 0.20ドル(約32円) |
| Batch API(入力/出力) | 4ドル(約640円)/20ドル(約3,200円) |
| fast mode(入力/出力) | 16ドル(約2,560円)/80ドル(約12,800円) |
Batch API(急ぎでない処理をまとめて送り、結果をあとで受け取る方式)を使えば、入力も出力も半額になります。
100万トークンの長い資料を読ませても、単価は上がりません。
米国内だけで処理させる指定をした場合は、すべての項目が1.1倍になります。
ほかのClaudeモデルとの単価の比較は、次の表のとおりです。
| モデル | 入力 | 出力 |
|---|---|---|
| Fable 5.2 | 8ドル(約1,280円) | 40ドル(約6,400円) |
| Opus 5.5 | 4ドル(約640円) | 20ドル(約3,200円) |
| Sonnet 5.5 | 2ドル(約320円) | 10ドル(約1,600円) |
| Haiku 5.5(10万トークン以下) | 0.10ドル(約16円) | 0.50ドル(約80円) |
単価だけを比べると、Opus 5.5のちょうど2倍です。
例えば入力1万トークン・出力2,000トークンの依頼なら、入力0.08ドル(約13円)と出力0.08ドル(約13円)で0.16ドル(約26円)、同じ量をOpus 5.5に頼めば0.08ドル(約13円)になります。
実際には推論にもトークンを使うため、出力の量は依頼の中身と推論の深さで増えます。
参考:Pricing(Claude Platform Docs)
Claude Fable 5.2を使えるプランと利用条件
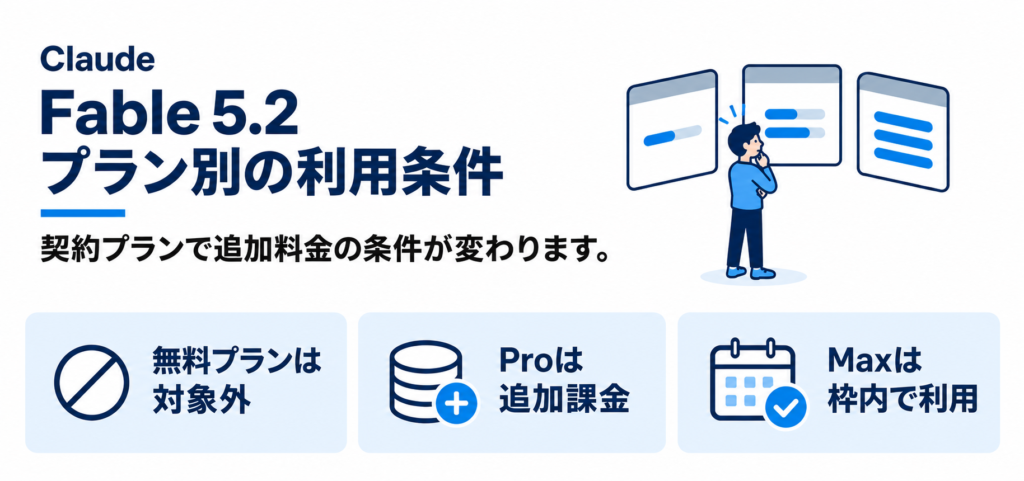
Claude Fable 5.2をclaude.aiで使えるかどうかと支払い方は、契約しているプランによって変わります。
プランごとの月額とFable 5.2の扱いを、2026年11月14日時点の公式の料金ページをもとに表にまとめました。
| プラン | 月額 | Fable 5.2の扱い |
|---|---|---|
| Free | 0円 | 使えない |
| Pro | 20ドル(約3,200円)/年払いは月17ドル(約2,720円) | 使用量クレジットで支払う |
| Max | 100ドル(約16,000円)から | 週の上限の50%まで追加料金なし |
| Ultra | 200ドル(約32,000円) | 週の上限の50%まで追加料金なし |
| Team標準席 | 1席25ドル(約4,000円)/年払いは月20ドル(約3,200円) | 使用量クレジットで支払う |
| Teamプレミアム席 | 1席125ドル(約20,000円)/年払いは月100ドル(約16,000円) | 週の上限の50%まで追加料金なし |
| Enterprise | 1席20ドル(約3,200円)+利用分 | 契約の形で変わる |
同じ有料プランでも、Fableが月額に含まれるプランと、別払いになるプランに分かれています。
ここでは、プランごとの条件と、すでに終了した公開記念の特典の内容を紹介します。
無料プランではFable 5.2を選べない
Claude Fable 5.2は有料プラン専用のモデルで、Freeプランでは使えません。
claude.aiで試すには、少なくともProプランへの登録が必要です。
公開記念の特典も、Freeプランは対象外でした。
プランを上げずに試したい場合は、APIで少しだけ呼び出す方法もあります。
ただしAPIはキーを発行してプログラムから呼び出す開発者向けの方法で、チャット画面のようには使えません。
APIはclaude.aiのプランとは別の契約で、入力8ドル(約1,280円)・出力40ドル(約6,400円)の単価で使った分だけを支払う仕組みです。
短い質問を数回送るだけなら費用は小さく収まるため、まずAPIで手元の資料を読ませて、結果に納得してからプランを選ぶ順番もとれます。
参考:Claude Fable models on your plan(Claude Help Center)
ProとTeam標準席は使った分だけ追加で払う
ProプランとTeamプランの標準席では、Claude Fable 5.2の利用分がプランの上限に含まれず、使用量クレジットから支払います。
使用量クレジットとは、月額料金とは別に、使った量に応じて支払う利用枠のことです。
つまりPro加入者がFableを使うと、月額20ドル(約3,200円)とは別の支払いが発生します。
Proのまま毎日Fableを使う予定なら、週の上限の半分までが含まれるMaxプランと費用を比べてみてください。
参考:Claude Fable models on your plan(Claude Help Center)
MaxとUltraは週の上限の半分まで追加料金なしで使える
MaxプランとUltraプランでは、週の利用上限のうち最大50%までをClaude Fable 5.2に使えます。
追加料金はかからず、Teamのプレミアム席も同じ扱いです。
注意したいのは、50%ぶんの枠が新しく増えるのではなく、今ある週の上限の半分までをFableに回せるという意味である点です。
Fableで半分を使い切ったあとは、残りの枠をOpus 5.5などほかのモデルに使います。
Fableを続けて使いたい場合、超えた分は使用量クレジットでの支払いです。
ほかのモデルで週の上限を使い切った場合も、Fable用の枠が別に残るわけではありません。
参考:Claude Fable models on your plan(Claude Help Center)
Enterpriseは契約の形で使える条件が変わる
Enterpriseプランでは、契約の種類と席の種類によってClaude Fable 5.2の扱いが分かれます。
従来の席課金型の契約では、プレミアム席はMaxと同じく週の上限の50%まで含まれます。
標準席で使えるのは、組織が使用量クレジットを有効にした場合だけです。
利用量課金型の契約なら、支払いはAPIの標準料金です。
また公開から7日間は、管理者がオンにしない限り社員はFable 5.2を選べません。
7日が過ぎると、Fableを許可しているロールへ自動で追加される仕組みです。
自動で追加されるのを避けたい管理者は、事前にオプトアウトしておきましょう。
参考:Claude Fable models on your plan(Claude Help Center)
Pro向けの公開記念特典は11月16日で終了した
Claude Fable 5.2の公開記念として、Anthropicは有料プラン向けに期間限定の特典を用意していました。
ProとTeam標準席では、2026年11月16日23時59分(米国太平洋時間)まで、週の上限の50%まですべてのFableモデルを追加料金なしで使えました。
日本時間では、11月17日16時59分にこの特典は終了しています。
11月9日午前10時(米国太平洋時間)より前から有料で契約していた人に付いたリセットも、同じ日時に失効しました。
一方、MaxとUltra、Teamと旧来のEnterpriseのプレミアム席に契約期間に応じて付いた1〜3回のリセットは、2027年3月8日まで使えます。
特典の期間が終わったため、現在Pro・Team標準席でFableを使う分は、使用量クレジットでの支払いです。
参考:Claude Fable 5.2 launch offers(Claude Help Center)
Claude Fable 5.2の使い方
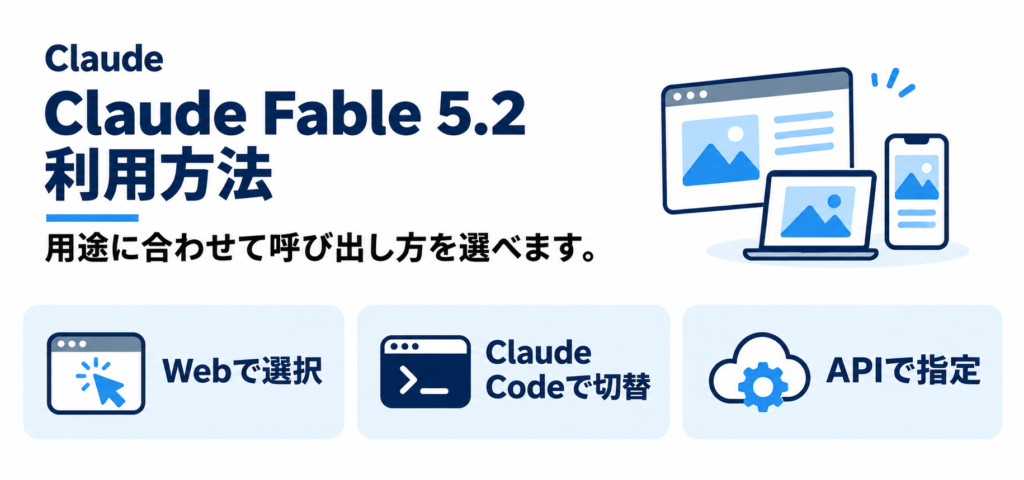
Claude Fable 5.2は、claude.aiのアプリ・Claude Code・API・クラウドサービスの4つの経路で使えます。
個人のプランでは、公開後も初期設定のモデルは変わらないため、使うときは自分でFable 5.2を指定する必要があります。
推論の深さ(effort)の初期設定も経路ごとに違い、アプリとClaude Codeはmedium、APIはhighです。
ここでは、それぞれの経路での切り替え方を紹介します。
claude.aiのモデル選択でFable 5.2を選ぶ
claude.aiでは、チャットの入力欄の右下にあるモデル名の表示から「Fable 5.2」を選ぶと切り替わります。
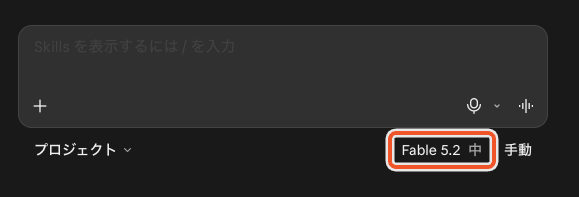
Web版・デスクトップアプリ・スマホアプリのどれでもモデルの選択からFable 5.2を選べ、Microsoft 365との連携などほかの機能でも使えます。
選んだあとの使い方はほかのモデルと同じで、チャットに依頼を書くだけです。
例えば決算資料のPDFを添付してFable 5.2に次のように頼めば、グラフの数値を読み取って表にまとめさせられます。
「添付したPDFの3ページ目にある売上推移のグラフを読み取り、年ごとの売上を表にまとめてください。」
返ってきた表は、元のグラフと数値を1、2か所突き合わせてから使いましょう。
参考:Claude Fable models on your plan(Claude Help Center)
Claude Codeでモデルを切り替えて呼び出す
Claude Codeでは、バージョン2.1.321以降に更新したうえで、/model fable と入力するとClaude Fable 5.2に切り替わります。
起動するときからFable 5.2を使いたい場合は、ターミナルで次のように打ちましょう。
ターミナル
claude --model fable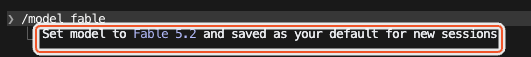
Pro・Max・Ultraの設定に claude-fable-5-1 を保存していた人は、自動で fable に移り、5.2が使われます。
Claude Codeでの推論の深さは初期設定でmediumのため、長い作業を任せるときは設定を上げて試してください。
推論の深さの変え方は、公式ドキュメントのModel configurationのページにまとめられています。
Claude Code自体の始め方とプランごとの料金は以下記事にまとめてあるので、まだ導入していない方はぜひ参考にしてください。
参考:Model configuration(Claude Code Docs)
APIでモデル名と推論の深さを指定する
APIでは、モデル名に claude-fable-5-2 を指定し、必要に応じて推論の深さ(effort)を選びます。
effort はlow・medium・high・xhigh・max の5段階で、APIでの初期設定はhighです。
Python
response = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=4096,
    messages=[{"role": "user", "content": "..."}],
    output_config={"effort": "high"},
)公式は、まずhighで試し、効果を確かめられた難しい作業だけxhighに上げるよう勧めています。
max は性能の上限を測るときのように、時間とトークンを気にしなくてよいまれな作業向けの設定です。
Fable 5.2では推論が常にオンで、推論を止める指定はできません。
temperature などの出力のばらつきを決める値も送らないよう、公式が案内しています。
参考:Effort(Claude Platform Docs)
クラウドサービス経由でAPIを呼び出す
Claude Fable 5.2は、AnthropicのAPIのほか、主要なクラウドサービスからも呼び出せます。
Amazon Bedrockで使うモデル名は global.anthropic.claude-fable-5-2 などで、対応するのはbedrock-runtimeのエンドポイントだけです。
Google CloudではAnthropicが運営する形とGoogleが運営する形の両方で提供され、モデル名は claude-fable-5-2 です。
Microsoft Foundryも、同じモデル名で使えます。
AWS上でClaudeの開発者向け環境を使えるClaude Platform on AWSも、提供先の1つです。
会社ですでに契約しているクラウドがあれば、請求や権限の管理をそのクラウドにまとめられます。
参考:What’s new in Claude Fable 5.2(Claude Platform Docs)
Claude Fable 5.2とOpus 5.5・Sonnet 5.5の使い分け方
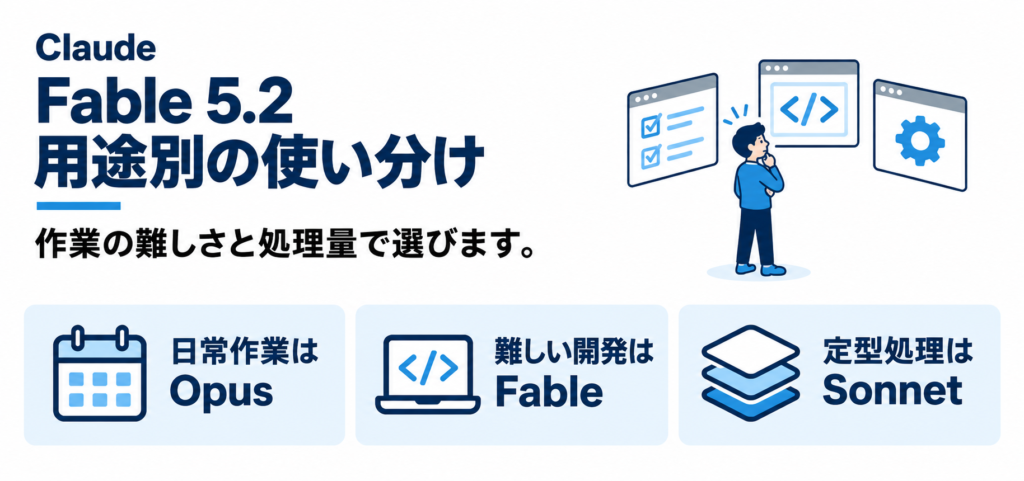
Claude Fable 5.2とほかのモデルの使い分けは、作業の難しさと費用の釣り合いで決まります。
公式は、まずOpus 5.5を使い、難しい作業はFable、大量の軽い作業はSonnet 5.5やHaiku 5.5に回すよう勧めています。
単価はOpus 5.5の2倍でも、推論の深さをhighにしたFable 5.2は、採用されるコードの評価でmax(最高設定)のOpus 5.5とほぼ同じ45.3%を、1件あたり約半分の費用で出しました。
ここでは、作業の種類ごとに向いているモデルを紹介します。
日常の文章作成やコード修正ならOpus 5.5
メールや資料の下書き、調べもの、小さなコード修正のような日々の作業には、Opus 5.5がおすすめです。
Anthropicは、Opus 5.5を日常の作業で最も頼れるモデルと位置づけています。
単価は入力4ドル(約640円)・出力20ドル(約3,200円)とFableの半分で、プランで使う場合も週の上限の減り方が穏やかです。
パソコンの画面操作の評価では、Opus 5.5が87.2%と、Fableとの差は2ポイントほどにとどまります。
普段の作業で結果に不満がなければ、切り替える理由は薄いでしょう。
Fableに切り替えるのは、推論の深さを上げてもOpus 5.5で結果が足りなかったときで十分です。
参考:What’s new in Claude Fable 5.2(Claude Platform Docs)
数日がかりの開発や原因不明の不具合ならFable 5.2
大きなプログラムの作り直しや、原因がわからない不具合の調査には、Claude Fable 5.2が向いています。
Anthropicの実験では、エンジニアがFable 5.2に試作のOS設計を任せ、1,000を超えるサブエージェント(作業を分担する小さなAI)が8日間かけてコードを書き、テストし、見直しました。
完成したOSはノートパソコンで起動し、ディスクやキーボードの制御からログイン画面まで備えていたと報告されています。
公式もこのモデルを、数時間から数日続く長い作業に向くモデルとして打ち出しています。
ただし長時間動かすほど費用がかかるため、まずは小さな範囲で試してから任せる範囲を広げましょう。
参考:Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic)
大量の定型処理ならSonnet 5.5かHaiku 5.5
問い合わせの分類や文書からの項目の抜き出しのように、同じ処理を大量に繰り返す作業には、Sonnet 5.5かHaiku 5.5がおすすめです。
入力の単価は、Sonnet 5.5がFable 5.2の4分の1、Haiku 5.5は10万トークン以下なら80分の1です。
難しい判断が要らない作業を最上位モデルに任せても、結果の差は小さいまま費用だけが膨らみます。
まずHaiku 5.5で試し、精度が足りなければSonnet 5.5に上げる順にすると、無駄な出費を抑えられます。
Sonnet 5.5の料金と性能は以下記事で詳しく比べているので、Opus 5.5との違いも確かめたい方は読んでみてください。
小さいモデルの相談役を置くならFable 5.2
Claude Fable 5.2は、作業を直接こなすだけでなく、ほかのモデルの相談役としても使えます。
Advisorは、Haiku・Sonnet・Opusが作業の途中で迷ったときに、上位のモデルへ判断を仰ぐ使い方です。
Orchestratorと呼ばれる使い方では、最上位モデルが全体の計画を立て、細かい作業を小さいモデルに割り振ります。
どちらも単価の高いモデルを使う場面が難しい判断だけに絞られるので、全体の費用を抑えながら精度を上げる方法として有効です。
なお、APIの advisor ツールでFable 5.2を作業役にする場合は、相談役も5.2かMythos 5.2にする必要があります。
参考:What’s new in Claude Fable 5.2(Claude Platform Docs)
Fable 5.1からClaude Fable 5.2へ乗り換える前に知っておくべき注意点
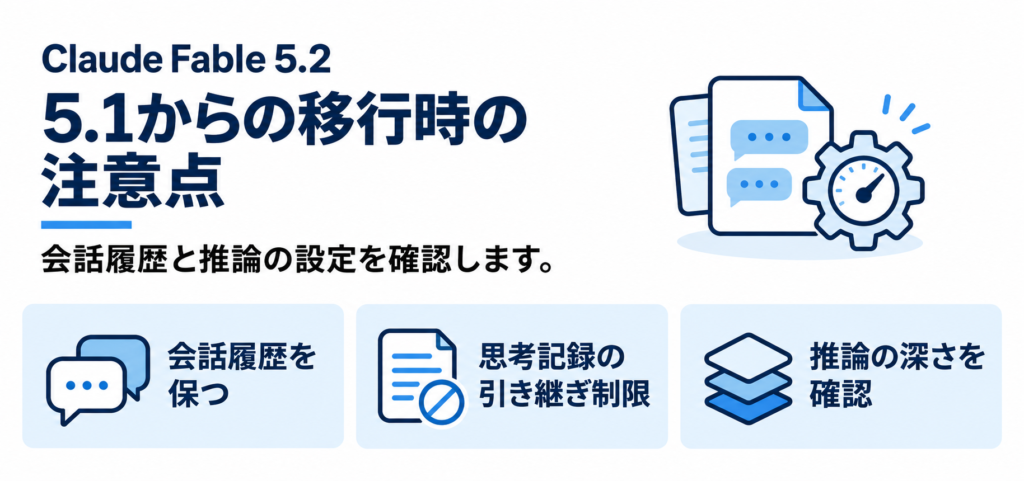
Fable 5.1からClaude Fable 5.2への乗り換えでは、モデル名を変えるだけでは動かなくなる場合があります。
会話の履歴と思考の記録の扱いは、自社のシステムからAPIを呼び出す人だけに関わる変更です。
claude.aiやClaude Codeでは、送る内容をアプリ側が組み立てるため影響しません。
一方、推論を省かない動きと途中で作業を切り上げる動きは、アプリで使う場合にも起きる挙動の変化です。
会話の履歴を書き換えて送るとエラーで止まる
Claude Fable 5.2では、過去の会話を書き換えて送ったリクエストが、エラーで拒否されます。
APIでは呼び出す側が毎回それまでの履歴をまとめて送る仕組みで、5.2はその履歴が前回と一致しているかを確かめます。
システムへの指示やツールの定義、過去のメッセージを途中で変えた場合に返ってくるのは、400エラーです。
公式はこの挙動を、Fable 5.1から変わった4つの点の1つに挙げています。
会話を続けるときは、過去の部分には手を加えず、新しいメッセージを後ろに足していきましょう。
古いメッセージを削ったり要約に置き換えたりして履歴を軽くする作りは、この変更の影響を受けます。
参考:What’s new in Claude Fable 5.2(Claude Platform Docs)
途中で5.1やOpus 5.5へ思考の記録を引き継げない
Claude Fable 5.2が回答の前に残す思考の記録は、Fable 5.2とMythos 5.2でしか読めません。
会話の途中でFable 5.1やOpus 5.5に切り替えて続きを任せる作りにしていると、5.2が考えた内容を次のモデルが活かせなくなります。
難しい部分だけ5.2に任せ、残りを安いモデルに渡す仕組みを組んでいる場合は、受け渡しの方法を見直してください。
同じく5.2で変わった点として、パソコン操作用の古いツール computer_20251124 は、Amazon Bedrock以外では400エラーになりました。
使っている場合は、新しい computer_toolset_20260801 への切り替えが必要です。
参考:What’s new in Claude Fable 5.2(Claude Platform Docs)
「考えずに答えて」と頼んでも推論を省かない
Claude Fable 5.2は、プロンプトで「考えずに答えて」と指示しても、推論の深さがmedium以上なら回答の前に推論します。
high以上の設定では、推論を挟まない回答はほとんどありません。
推論にもトークンを使うため、軽い質問でも出力のトークンが増え、APIでは費用が、プランでは使用量がかさみます。
すぐに短い答えがほしい質問は、推論の深さを下げるか、Opus 5.5やSonnet 5.5に頼みましょう。
Claude Codeで短い確認だけをしたいときも同じで、推論の深さを下げるほうが確実です。
参考:Prompting Claude Fable 5.2(Claude Platform Docs)
推論の深さを下げると長い作業を途中で切り上げる
推論の深さをlowやmediumにしたClaude Fable 5.2は、長い作業の途中で残りの作業を一覧にして、回答を終えることがあります。
公式のプロンプトの手引きでも、低い設定では作業の途中でターンを終える場合があると説明されています。
Claude Codeは推論の深さの初期設定がmediumなので、大きな作業を頼むときほど注意が必要です。
長い作業を最後まで任せたいときは、推論の深さをhigh以上に上げて試してください。
乗り換えるときは、モデル名だけ変えて終わりにせず、推論の深さを変えながら結果と費用を測り直しましょう。
参考:Prompting Claude Fable 5.2(Claude Platform Docs)
Claude Fable 5.2を使うときに知っておくべき注意点
Claude Fable 5.2は性能が高いぶん、使い方によっては費用や情報の扱いで負担が大きくなります。
アプリで使う人にもAPIで使う人にも関わる点なので、使い始める前に確かめておきましょう。
特に費用と使用量の上限は、5.1から単価が下がった今も、ほかのClaudeモデルより重い負担になります。
ここでは、Fable 5.2を使うときに知っておきたい4つの注意点を紹介します。
ほかのモデルより早く使用量の上限に達する
Claude Fable 5.2は、ほかのClaudeモデルより速いペースで使用量の上限を消費します。
同じ1回の依頼でも、上限から差し引かれる量が大きくなる仕組みです。
MaxやUltraでも、Fableを多用すると週の上限の半分に早く届き、その週はFableを追加料金なしで使えなくなります。
設定の使用量(Usage)の画面で、Fableに使った量を確かめながら使いましょう。
Max・Ultraなどで公開記念のリセットが残っている場合は、同じ画面から使うと、Fableに使った分を戻せます。
簡単な質問はOpus 5.5に回し、Fable 5.2は難しい作業に絞ると、上限まで余裕を残せます。
参考:Claude Fable models on your plan(Claude Help Center)
入力した内容が最低30日間保存される
Claude Fable 5.2に送った入力と出力は、最低30日間保存されます。
データを保存しない契約(ゼロデータ保持)の対象外で、Anthropicが個別に認めた場合を除いて30日の保存が必須です。
社外秘の資料や個人情報を扱う会社は、社内の規程で30日の保存が認められるかを先に確かめてください。
APIを自社のサービスに組み込む場合は、自社の利用者が入力した内容も30日保存される前提で、利用規約やプライバシーポリシーの記載を見直しましょう。
参考:What’s new in Claude Fable 5.2(Claude Platform Docs)
危険と判定された依頼は別のモデルが答える
Claude Fable 5.2に危険と判定される依頼を送ると、回答が止められるか、別のモデルに切り替わります。
攻撃用のプログラム作成のような依頼に代わりに答えるのはOpus 4.8で、生物学の危険な分野や一部のAI開発の話題ではOpus 5です。
APIでは、拒否された回答が stop_reason: "refusal" として返ってきます。
APIで別のモデルに答え直させるには、ベータ版のサーバー側の切り替え機能か、自前の再試行の仕組みを用意する必要があります。
正当なセキュリティ診断でも切り替わることがあり、その場合に答えているのはFable 5.2より性能の低いモデルです。
重要な調査では、どのモデルが答えたかと結果の中身を確かめてから使ってください。
参考:What’s new in Claude Fable 5.2(Claude Platform Docs)
単価が下がっても推論を深くすると費用が増える
Claude Fable 5.2の単価はFable 5.1の8割になりましたが、1回の依頼の費用が必ず下がるわけではありません。
推論の深さをxhighや max に上げると、回答の前に考える量が増え、そのぶん出力のトークンが増えるためです。
大きな作業を複数のサブエージェントに分けて進めると、使うトークンはさらに増えます。
逆にhighの設定では、コードの評価でmax(最高設定)のOpus 5.5とほぼ同じ点を、1件あたり約半分の費用で出したという公式の結果もあります。
APIで使う場合は、推論の深さを変えながら1回あたりの費用を測り、上限額を決めてから本番の作業に使いましょう。
参考:Effort(Claude Platform Docs)
Claude Fable 5.2のよくある質問
- Claude Fable 5.2は無料で使えますか?
-
Claude Fable 5.2は無料では使えません。
Freeプランでは選べないため、Pro以上の有料プランかAPIの契約が必要です。
Proプランの場合は、月額とは別に使用量クレジットでの支払いになります。
- Fable 5.1はいつまで使えますか?
-
2026年11月14日時点で、Fable 5.1の提供終了は告知されていません。
公式の予定では、2027年9月1日より前に提供を終えることはないとされています。
- Claude Codeで最初からFable 5.2を使えますか?
-
Claude Codeでは、Fable 5.2は最初から選ばれているモデルになりません。
/model fableで切り替えるか、起動時にclaude --model fableと指定してください。 - 日本語の性能も上がっていますか?
-
日本語に絞ったFable 5.2の評価結果は、公式には公表されていません。
普段扱う日本語の資料を5.1と5.2の両方に読ませて、結果を比べると判断しやすくなります。
- Fable 5.2とOpus 5.5はどちらを使えばいいですか?
-
普段の作業はOpus 5.5、数日がかりの開発や原因のわからない不具合の調査はFable 5.2がおすすめです。
Opus 5.5で結果が足りなかった作業から切り替えると、費用を抑えながら性能の差を活かせます。
- Claude Fable 5.2はいつまで使えますか?
-
公式の予定では、Claude Fable 5.2は2027年11月9日より前に提供を終えることはないとされています。
まとめ:Claude Fable 5.2は5.1より安く速く難しい作業を任せられる
Claude Fable 5.2は、難しい技術作業を長時間任せられるClaudeの最上位モデルです。
5.1と比べると、API料金が入力8ドル(約1,280円)・出力40ドル(約6,400円)へと2割下がり、回答も最大3割速くなりました。
公表された主な10項目の評価でFable 5.1とOpus 5.5を上回り、仕事の代行やグラフの読み取りで伸びが目立ちます。
claude.aiでは有料プラン専用で、Max・Ultraは週の上限の半分まで追加料金なし、Pro・Team標準席は使用量クレジットでの支払いになります。
使い始めるときは、アプリのモデル選択か、Claude Codeの /model fable、APIのモデル名の指定で切り替えましょう。
ただし単価はOpus 5.5の2倍で、使用量の減りも速いため、日々の作業はOpus 5.5に任せてください。
数日がかりの開発や原因のわからない不具合の調査でFable 5.2を試し、費用と結果を比べながら使う範囲を決めていくのがおすすめです。
コメント