「Claude Codeにどこまで情報を入れていいのかわからない」「学習させない方法があれば知りたい」と思っている方も多いのではないでしょうか。
企業の機密情報や顧客データを含むコードを扱う場合、セキュリティ面の懸念は特に大きくなります。
実は、Claude Codeでデータが学習に使われるかどうかはプランによって異なり、適切な設定を行えば学習を防げます。
この記事では、プランごとの学習設定の違いと具体的なオプトアウト手順、安全に使うための運用ポイントをまとめているので、ぜひ参考にしてください。
また、Claude Code全般のセキュリティ対策は以下で解説しています。
生成AIパスポート取得者が内容をチェック
当サイトの記事は、生成AIに関する基礎知識やリスク、適切な活用方法などを学ぶ「生成AIパスポート」の取得者が内容を確認しています。情報の正確性や分かりやすさを意識した記事づくりに努めています。
Claude Codeはデフォルトでデータを学習するのか?
Claude Codeを通じて送信したデータが、Anthropicによるモデル改善に使われるかどうかは、ログインしているアカウントの種別によって決まります。
個人向けのFree・Pro・Maxプランでは、初期設定のままだとデータが学習対象になる可能性があります。
一方、企業向けのTeam・Enterprise・APIプランでは、標準で学習対象外となっており、特別な設定変更は必要ありません。
AWS BedrockやGoogle Vertex AI、Foundry経由で利用している場合も同様に、初期状態でデータ学習は行われない仕組みです。
どのプランを使っているかによって必要な対応が変わるため、まず自分のプランを確認することが最初のステップになります。
プラン別|Claude Codeの学習設定の違い【2026年最新比較】
Claude Codeのデータ学習への利用は、プランごとにルールが異なります。
「設定を変えなければいけないプラン」と「最初から学習対象外のプラン」が存在するため、自分の利用状況を正確に把握しておくことが大切です。
以下では、代表的なプランごとの学習設定の違いを整理します。
Free・Pro・Maxはデフォルトで学習対象になっている
個人向けのFree・Pro・Maxプランでは、初期設定のままClaude Codeを使うと、送信したデータがAI学習に利用される可能性があります。
これはclaude.aiにログインして使う場合に適用されるルールです。
ただし、プライバシー設定を変更すれば、以降の新規チャットから学習対象外になります。
設定変更前のデータは遡及して除外できないため、早めに対応しておくのが得策です。
Team・Enterprise・APIは標準で学習対象外になっている
Team・Enterprise・APIプランは、初期設定の段階でユーザーデータがAI学習に使われない仕組みになっています。
商用利用向けの規約(Commercial Terms)が適用されるため、個人向けプランとは異なる扱いです。
また、AWS BedrockやGoogle Vertex AI、Foundry経由でClaude Codeを利用している場合も、同様に学習対象外となっています。
Anthropicが提供するDeveloper Partner Programに明示的に参加した場合を除き、追加の設定変更は不要です。
プラン選びがセキュリティ対策の第一歩になる
機密性の高いコードや個人情報を扱う場合、プランの選択がセキュリティ対策の起点になります。
Free・Pro・Maxプランは費用を抑えて始めやすい反面、データ学習の初期設定を自分で変更する必要があります。
一方、Team・Enterprise以上であれば標準でデータ学習対象外となるため、設定変更の手間なくプライバシーを確保しやすい環境です。
複数人が使う職場環境や顧客情報を扱うケースでは、Team以上のプランを選ぶことを検討してみてください。
Claude Codeを学習させない設定手順3ステップ
Free・Pro・Maxプランを使っている場合、自分でプライバシー設定を変更する必要があります。
設定そのものは複雑ではなく、ブラウザの設定画面から数クリックで完了する内容です。
ただし、設定の変更だけでは対応しきれないケースもあるため、コマンドによる追加対策もあわせて紹介します。
ブラウザのプライバシー設定からデータ使用をオフにする
最も基本的な対策は、claude.aiのプライバシー設定画面からデータ利用をオフにすることです。
「settings/data-privacy-controls」にアクセスし、「Claudeの改善にご協力ください」と表示されているトグルをオフに切り替えると設定完了です。
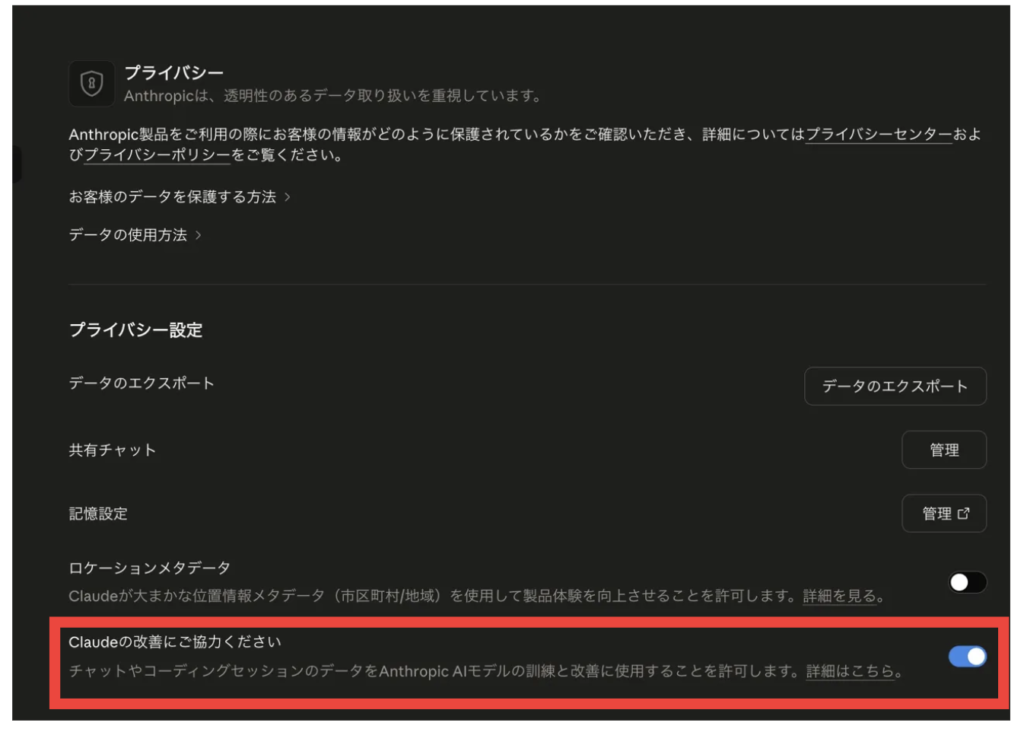
オフにした以降の新規チャットから学習対象外となり、データの保持期間が5年から30日へと短縮されます。
設定変更前にすでに学習に使われたデータは遡って取り消せないため、利用開始直後に設定しておくのが理想です。
「/feedback」コマンドの使用を控える
Claude Codeには「/feedback」というコマンドが用意されており、実行するとそのセッション内の全会話履歴(コードを含む)がAnthropicに送信される仕組みになっています。
送信されたデータは最大5年間保持され、製品改善に使用される可能性があります。
プライバシー設定でデータ学習をオフにしていても、このコマンドは例外的に送信が行われる点に注意が必要です。
起動設定を変えてAnthropicへのデータ送信を遮断する
Claude Codeは、応答速度やエラー発生率などの利用状況データをAnthropicに自動送信していますが、この通信は無効化が可能です。
送信内容にプロンプトやコードの中身は含まれないため、モデル学習とは別の問題ですが、社内での利用や高いプライバシー基準が求められる場面では対策しておく価値があるでしょう。
ターミナルに「CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1」と入力して実行すると、Claude Codeが起動するたびに自動送信されるデータをまとめてオフにできます。
Claude Codeを安全に使う追加対策4つ
プライバシー設定の変更だけで、完全なセキュリティを確保できるわけではありません。
Claude Codeが扱うデータの種類や、組織のセキュリティ要件によっては、さらに踏み込んだ対策が必要になる場合があります。
ここでは、設定変更と組み合わせることで効果を高める4つの追加対策を紹介します。
.claudeignoreで機密ファイルをアクセス対象から除外する
Claude Codeは、プロジェクト内のファイルを参照して作業を進めるため、設定ファイルや認証情報がフォルダ内に含まれている場合、意図せずアクセス対象に含まれてしまうことがあります。
プロジェクトのルートに「.claudeignore」ファイルを作成し、除外したいファイルやフォルダを指定しておくと、Claude Codeがそれらにアクセスしないようになります。
パスワードや秘密鍵が記述された設定ファイルなど、外部に出すべきでない情報は、このファイルで明示的に除外しておきましょう。
Claudeがアクセスできるネットワーク範囲を制限する
Claude Codeはインターネット上のリソースにアクセスする機能を持っているため、組織によってはネットワーク接続の範囲を制限したほうが安全です。
企業でClaude Codeを使う場合、Claude Codeが接続できる外部サービスの範囲をあらかじめ絞っておくことが有効な対策になります。
特にWebFetch機能を使う際には、Claude Codeがアクセスするホスト名がAnthropicのサーバーに送信される仕組みがあるため、社内情報が流出しないよう注意が必要です。
会話履歴を定期的に削除する
データ学習設定をオフにしていても、送信されたデータはセキュリティ監視やトラブル対応のために一定期間サーバーに保持されています。
保持期間はオプトアウト状態では30日間となっています。
データをサーバーに残したくない場合は、会話履歴を定期的に削除しておくと安心です。
削除した会話はサーバーからも消えるため、定期的に不要な履歴を整理する習慣をつけておくとよいでしょう。
機密情報・個人情報の入力をそもそも避ける
設定や環境変数による対策を講じる以上に、機密性の高い情報を入力しないことが最も確実な対策です。
具体的には、氏名・住所・メールアドレスなどの個人情報、社内の売上情報や顧客データ、パスワードや認証鍵などは入力しないことが基本になります。
どうしてもコードに機密情報が含まれる場合は、該当部分を伏せ字に置き換えたり、ダミーデータに差し替えたりしてから入力するとよいでしょう。
細心の注意を払ったうえで利用することが、安心してClaude Codeを使い続けるための前提となります。
Claude Codeの学習をオフにするメリット・デメリット
データ学習をオフにすることで安全性は高まりますが、一定のトレードオフも生まれます。
どのような場面でメリットを得られるのか、また反対にどのような制限が生じるのかを事前に把握しておくことは、チームや組織の運用方針を決める際に役立ちます。
以下で、それぞれ詳しく見ていきましょう。
メリット:機密コードや顧客情報の流出リスクを下げられる
データ学習をオフにした場合、送信データの保持期間が5年から30日に短縮されます。
コードが長期間サーバーに残り続けるリスクを抑えられるため、顧客情報や独自ロジックを含むコードを扱う際の安心感につながります。
特に、取引先との契約でデータ管理方法に制約がある場合や、個人情報保護への対応が必要な業務では、学習オプトアウトが有効な選択肢の一つになるでしょう。
メリット:コンプライアンス要件に対応しやすくなる
企業によっては、業務データの外部送信や第三者利用を制限するセキュリティポリシーが設けられている場合があります。
データ学習をオフにした状態でClaude Codeを利用すれば、社内規定や業界ガイドラインへの準拠を示しやすくなるでしょう。
特に金融・医療・法律などの規制業種では、AIツール導入の前提として学習オプトアウトが求められるケースがあり、設定のオフが業務導入の条件になることもあります。
デメリット:AI精度の向上に貢献できなくなる
Anthropicは、ユーザーのデータをモデルの改善に活用することで、Claudeをより正確で使いやすいツールへと進化させてきました。
学習をオフにすると、自分の利用データが今後の改善に反映されなくなるため、AIの精度向上へ貢献したいと考える方にはデメリットに映るかもしれません。
ただし、精度への影響は多くのデータと開発全体の方針に依存するものであり、個人一人のオプトアウトによる影響は限定的といえるでしょう。
デメリット:一部機能やフィードバック連携が制限される
データ学習をオフにした状態では、一部の機能に影響が出ることがあります。
例えば、「/feedback」コマンドを無効化した場合、Claude Codeのバグや問題を開発チームに直接報告する手段が失われます。
また、データ送信をオフにすると、Claude Code側でのエラーや不具合が起きても自動で検知されにくくなる側面があるのも事実です。
こうした制限を理解したうえで、業務の用途や環境に合わせて設定を選択するのが現実的な判断です。
Claude Codeの学習設定に関するよくある質問
Claude Codeのデータ学習設定については、「どこまで有効なのか」「設定後の挙動はどう変わるのか」といった疑問を持つ方も多くいます。
ここでは、利用者からよく寄せられる質問とその回答をまとめています。
- 設定をオフにすれば、過去のデータも削除されますか?
-
過去のデータを遡及して除外することはできません。
オプトアウト設定は変更後の新規チャットから適用されます。
設定変更前に送信されたデータはすでにモデル改善に利用されている可能性があるため、Claude Codeの利用開始時に設定を済ませておくことが望ましいでしょう。
- 設定をオフにしても、Claude Codeは普通に使えますか?
-
基本的な使い方に影響はなく、コードの作成や修正といった通常の操作はそのまま行えます。
ただし、フィードバックボタンを押したときのデータ送信など、一部の連携機能が制限される場合があります。
- 設定をオフにしたかどうか、確認する方法はありますか?
-
claude.aiの設定画面にアクセスすると、現在の設定状態を確認できます。
「Claudeの改善にご協力ください」のトグルがオフになっていれば、学習対象外の状態です。
- 会社のパソコンでClaude Codeを使う場合、個人で設定を変えれば大丈夫ですか?
-
個人アカウントで利用している場合は、プライバシー設定から変更できます。
ただし、会社のシステムや契約プランによってはIT担当者やシステム管理者への確認が必要になる場合があります。
業務での利用は社内の運用ルールもあわせて確認しておきましょう。
まとめ:Claude Codeは設定と運用ルールで安全に使える
Claude Codeのデータ学習の有無はプランによって異なります。
Free・Pro・Maxプランを使っている場合は、claude.aiのプライバシー設定画面でデータ利用をオフに切り替える設定が必要です。
一方、Team・Enterprise・API、またはBedrock・Vertex AI・Foundry経由で利用している場合は、初期設定で学習対象外となっているため、特別な設定変更は不要です。
設定変更に加えて、「/feedback」コマンドの使用を控えることや、環境変数「CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1」を設定することで、不要な通信も遮断できます。
.claudeignoreを使った機密ファイルの除外、会話履歴の定期削除、そもそも個人情報・認証情報を入力しないといった運用上の工夫を組み合わせることで、より安全なClaude Code環境を整えられます。
設定は一度行えばすぐに効果が出るものも多いため、まず自分のプランを確認し、本記事で紹介した対策から取り組んでみてください。
コメント